კომპანიას ახალი სისტემების ფასები, ჩაშვების ზუსტი თარიღები და სრული წარმადობის მაჩვენებლები ჯერ არ გაუმჟღავნებია.
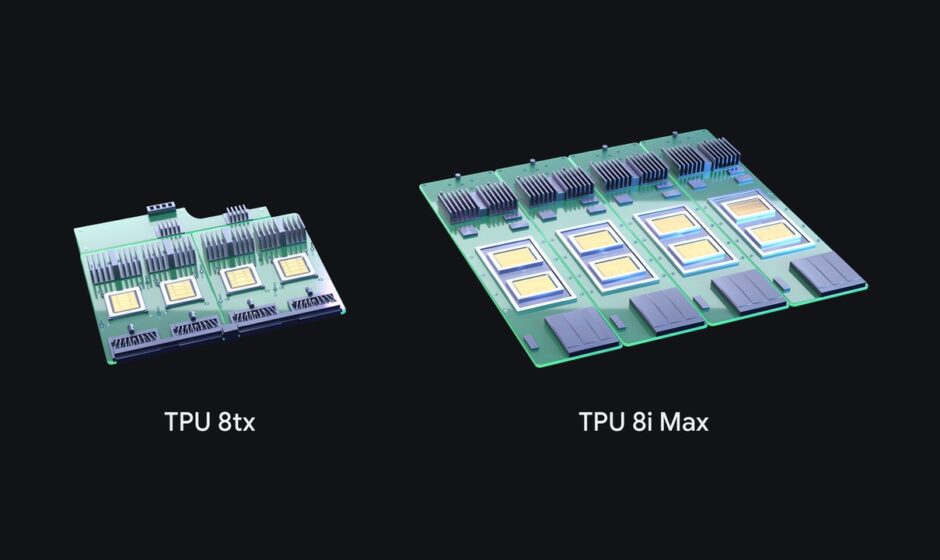
9 ნოემბერს Google-მა ოფიციალურ ბლოგში თავისი მერვე თაობის ხელოვნური ინტელექტის ჩიპების ორი ახალი სისტემა, TPU 8tx და TPU 8i Max, წარადგინა. კომპანიამ ერთი სისტემა მკაცრად დაცული მონაცემებისთვის შექმნა, მეორე კი, დიდი მოცულობის ინფორმაციის ერთდროულად დასამუშავებლად. Google-ისთვის ეს პირველი შემთხვევაა, როცა ერთ წელიწადში ოთხი ახალი TPU სისტემა გამოუშვა, რითაც AI აპარატურის ბაზარზე NVIDIA-სთან კონკურენციას პირდაპირ ამძაფრებს.
TPU, ანუ Tensor Processing Unit, Google-ის მიერ შექმნილი სპეციალური ჩიპია, რომელიც ხელოვნური ინტელექტის მოდელებს წვრთნის და ამუშავებს. აპრილში, კონფერენცია Google Cloud Next-ზე, კომპანიამ უკვე გვაჩვენა TPU 8t დიდი მოდელების გასაწვრთნელად და TPU 8i რეალურ დროში მსჯელობისთვის. Google-ის ცნობით, წინა თაობასთან შედარებით, ეს ჩიპები წვრთნის სისწრაფეს 2,7-ჯერ ზრდის, ხოლო მოდელის მუშაობის ფასისა და წარმადობის შეფარდებას 80 პროცენტით აუმჯობესებს. „ეს პირველი შემთხვევაა, როცა ერთ წელიწადში ოთხი TPU სისტემა წარვადგინეთ“, ვკითხულობთ კომპანიის განცხადებაში. როგორ მოასწრო კომპანიამ ეს ასე სწრაფად? Google-ში განმარტავენ, რომ სრულიად ახალი ჩიპის შექმნას წლები სჭირდება, მაგრამ მის გარშემო ახალი სისტემის, ანუ შეფუთვის, მეხსიერებისა და ქსელის აწყობა რამდენიმე თვეშიც შესაძლებელია.
მონაცემების დაცვა პირდაპირ ჩიპში
პირველი სიახლე, TPU 8tx, ეგრეთ წოდებული კონფიდენციალური გამოთვლებისთვის არის განკუთვნილი და მცირე ზომის მოდელების გაწვრთნაც შეუძლია. ჩვეულებრივ, როცა კომპიუტერი დაშიფრულ ინფორმაციას ამუშავებს, მუშაობის მომენტში მონაცემები მეხსიერებაში დროებით იხსნება და დაუცველი ხდება. TPU 8tx-ში დაცვა პირდაპირ აპარატურაშია ჩაშენებული, ამიტომ მონაცემები და თავად მოდელის შიდა პარამეტრები გამოყენების პროცესშიც სრულად იზოლირებული და დაცული რჩება.
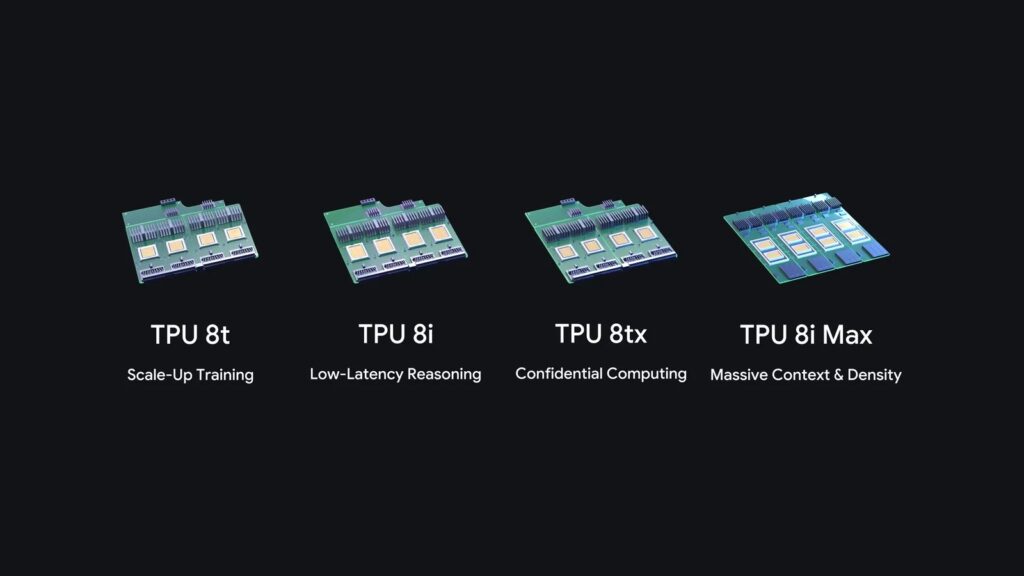
ეს სისტემა მთავრობებისა და მკაცრად რეგულირებული კომპანიებისთვისაა, რომლებსაც საიდუმლო მონაცემები და საკუთარი დახურული მოდელები აქვთ. ის TPU 8t-ის სილიკონს ეყრდნობა, მეხუთე თაობის AMD EPYC პროცესორებთან ერთად მუშაობს და Google-ის სწრაფ ქსელს, Boardfly-ს, იყენებს. შედეგად, გუნდებს შეუძლიათ, საკუთარ მონაცემებს მოარგონ მოდელები, დიდი მოდელებიდან უფრო პატარა ვერსიები გამოიყვანონ და ავტონომიური პროგრამები ისე გაწვრთნან, რომ მგრძნობიარე ინფორმაცია სხვა სერვერებზე არ გადაიტანონ.
გაორმაგებული მეხსიერება დიდი დავალებებისთვის
მეორე სისტემა, TPU 8i Max, ერთ კორპუსში ორ TPU 8i ჩიპს აერთიანებს. ეს ნიშნავს, რომ სისტემას, ჩვეულებრივ TPU 8i-სთან შედარებით, ორჯერ მეტი გამოთვლითი სიმძლავრე, ორჯერ მეტი შიდა მეხსიერება და მონაცემთა გატარების ორმაგი სიჩქარე აქვს. რატომ არის მეხსიერება ასეთი მნიშვნელოვანი დამოუკიდებლად მომუშავე AI პროგრამებისთვის? როცა ხელოვნურ ინტელექტს ერთდროულად მთელი პროგრამული კოდის ან რამდენიმესაათიანი ვიდეოს გაანალიზებას ავალებ, მას უზარმაზარი სამუშაო მეხსიერება, ანუ დიდი კონტექსტური ფანჯარა სჭირდება. TPU 8i Max სერვერის კარადაში იმავე ადგილს იკავებს, მაგრამ ორჯერ მეტ სილიკონს იტევს, რაც ყოველ კვადრატულ ფუტსა და დახარჯულ ვატზე მეტ სიმძლავრეს იძლევა.
აპარატურასთან ერთად, Google-მა პროგრამული მხარეც გაამარტივა, რათა დეველოპერები თავის ჩიპებზე გადაიყვანოს. გასულ თვეში კომპანიამ ღია კოდის სახით გახსნა TorchTPU, რომლის წყალობითაც PyTorch-ზე დაწერილი კოდი და Hugging Face-ის მოდელები პირდაპირ TPU-ზე ეშვება. სისტემას უკვე აქვს vLLM-ისა და SGLang-ის მხარდაჭერა, ხოლო დეველოპერული ხელსაწყოების ახალი ღია ნაკრები სატესტო რეჟიმში უკავშირდება კოდირების ისეთ პოპულარულ პროგრამებს, როგორებიცაა Claude Code, Cursor და Google Antigravity. გასათვალისწინებელია, რომ წარმადობის ყველა მაჩვენებელი თავად Google-ის შეფასებაა და დამოუკიდებელ ტესტებს ჯერ არ დაუდასტურებია.
| თაობა | მერვე თაობის TPU (წელს გამოსული 4 სისტემა) |
| TPU 8tx პროცესორი და ქსელი | მე-5 თაობის AMD EPYC და Boardfly ქსელი |
| TPU 8i Max არქიტექტურა | 2 ცალი TPU 8i ჩიპი ერთ კორპუსში |
| TPU 8i Max წარმადობა | 2-ჯერ მეტი გამოთვლა, SRAM მეხსიერება და HBM გამტარობა TPU 8i-სთან შედარებით |
| TPU 8t წვრთნის სისწრაფე | წინა თაობაზე 2,7-ჯერ მაღალი |
| TPU 8i ფასი და წარმადობა | წინა თაობაზე 80%-ით უკეთესი შეფარდება |
| ფასი და გამოსვლის თარიღი | არ გამოცხადებულა |
წყარო: Google blog: Our newest TPUs: 8tx and 8i Max, built for the agentic era (9 Nov 2026) | Interesting Engineering: Google expands its chipset lineup with up to 80% better inference price performance (10 Nov 2026) | The Decoder: Google ships four TPU variants in one year as it ramps up competition with Nvidia (9 Nov 2026)
ეს სტატია შეიქმნა AI ხელსაწყოებით, პროცესში ადამიანის ჩართულობა დაახლოებით 10%-ია.