ღია კოდის მქონე მოდელი უკვე ხელმისაწვდომია, თუმცა Android-ის სისტემურ სერვისებში ის მხოლოდ უახლოეს კვირებში ჩაერთვება.
Google DeepMind-მა ახალი ღია საძიებო AI მოდელი – EmbeddingGemma 2 წარადგინა, რომელსაც ტექსტის, ფოტოების, ვიდეოსა და აუდიოს გაგება უშუალოდ მოწყობილობაში შეუძლია. სიახლის შესახებ კომპანიამ ოფიციალურ ბლოგსა და დეველოპერულ პორტალზე გამოქვეყნებულ მიმოხილვაში განაცხადა. სისტემა შექმნილია იმისთვის, რომ სმარტფონმა ან კომპიუტერმა ინტერნეტისა და ღრუბლოვანი სერვერების გარეშე შეძლოს ნებისმიერი ციფრული ფაილის შინაარსობრივი ძებნა.
რაში გვჭირდება ემბედინგის მოდელი?
მარტივად რომ ვთქვათ, ის სხვადასხვა სახის მონაცემს რიცხვების ერთიან ენად გარდაქმნის და სპეციფიკურ ვექტორულ სივრცეში ათავსებს. ამ ტექნოლოგიის დახმარებით შეგიძლიათ ტექსტური მოთხოვნით იპოვოთ კონკრეტული ფოტო პირად ალბომში ან ხმოვანი შეტყობინებით მოძებნოთ სასურველი მომენტი საათიან ვიდეოში. ავტორების თქმით, ეს პროცესი ლოკალურად მიმდინარეობს, რაც მომხმარებლის კონფიდენციალურობას სრულად იცავს და პასუხის მიღების პროცესს აჩქარებს.
არქიტექტურა და მოდულური აგებულება
EmbeddingGemma 2-ის მთავარი სიძლიერე მისი მოქნილობაა. მოდელი Gemma 4-ის არქიტექტურას ეფუძნება და ჯამში 740 მილიონი პარამეტრისგან შედგება. დეველოპერებს არ უწევთ სრული მოდელის ჩატვირთვა, თუ ამის საჭიროება არ აქვთ. ტექსტისა და კოდის ბლოკი სულ 270 მილიონ პარამეტრს მოიცავს. მას სურვილისამებრ შეგიძლიათ დაუმატოთ ხედვის მოდული, რაც ზომას 440 მილიონამდე გაზრდის, ან აუდიომოდული, რაც მას 570 მილიონამდე აიყვანს.
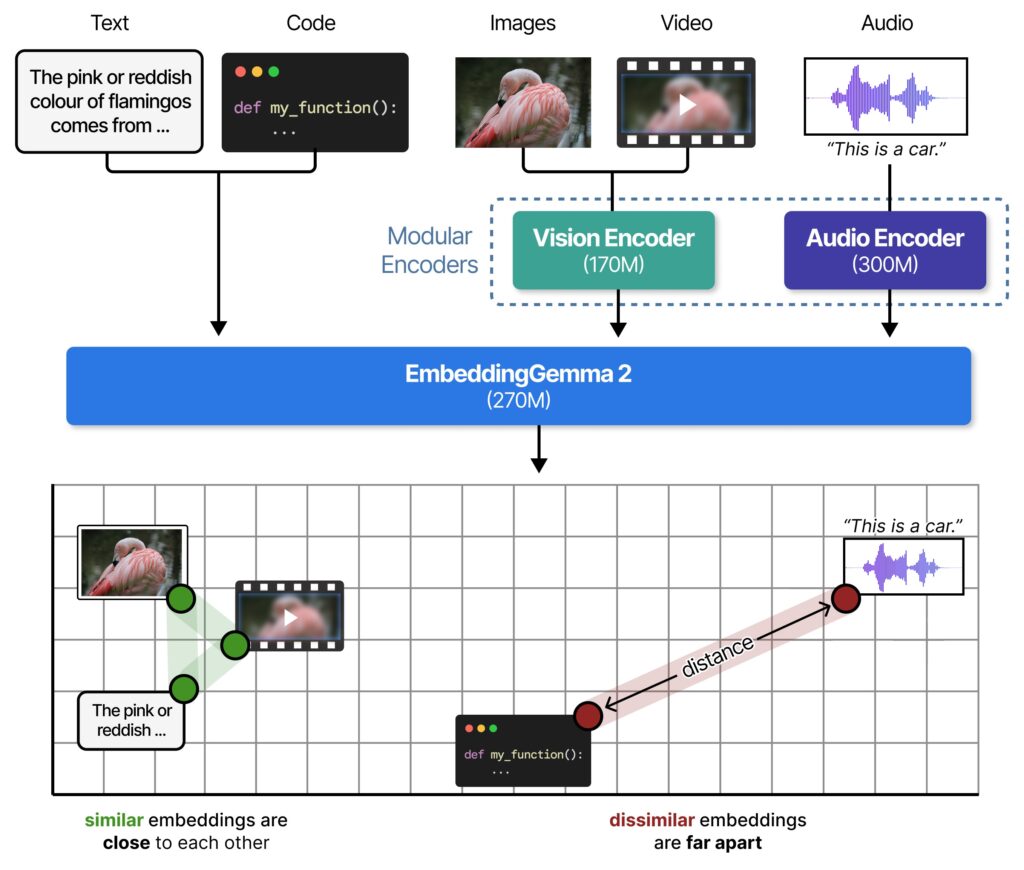
ეს დაყოფა განსაკუთრებით მნიშვნელოვანია სმარტფონებისთვის. ოფიციალური ტესტების მიხედვით, Google Pixel 11 Pro-ზე ტექსტური ვერსია ოპერატიულ მეხსიერებაში მხოლოდ 191 მეგაბაიტს მოიხმარს, ხოლო სრული მულტიმოდალური ვარიანტი – 567 მეგაბაიტს. ამასთანავე, მოდელი იყენებს მონაცემების შენახვის სპეციალურ ტექნიკას (MRL), რომელიც დეველოპერებს ვექტორების ზომის შემცირებისა და მეხსიერების თითქმის 6-ჯერ დაზოგვის საშუალებას აძლევს.
შესაძლებლობები და ეკოსისტემა
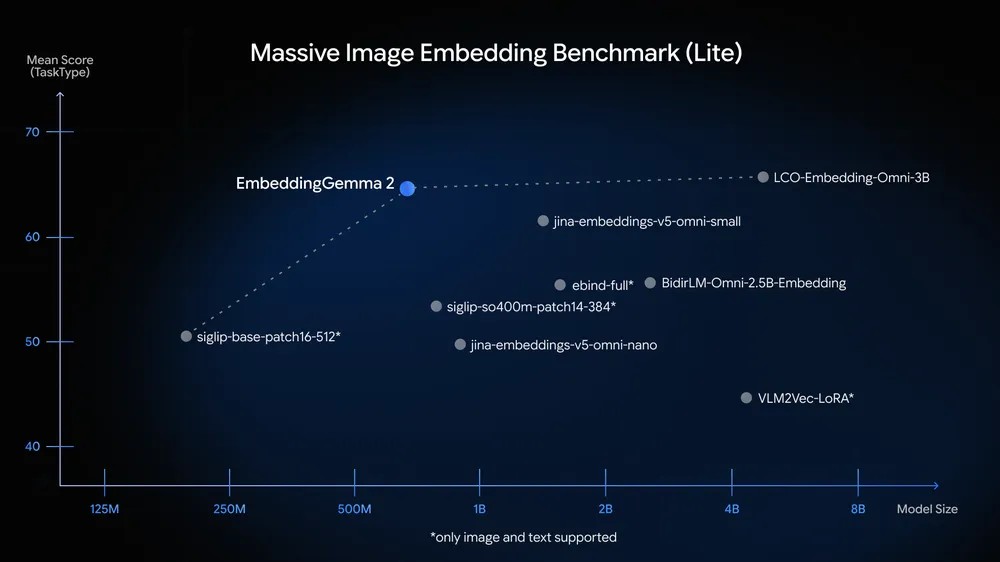
პირველ EmbeddingGemma-ს, რომელსაც 20 მილიონზე მეტი ჩამოტვირთვა ჰქონდა, მხოლოდ ტექსტის გაგება შეეძლო. ახალი თაობა კი სრულად მულტიმოდალურია და მისი კონტექსტის ფანჯარა ოთხჯერ გაიზარდა. 8,192 ტოკენის დახმარებით სისტემას შეუძლია ერთდროულად 5.5 წუთამდე აუდიო ან 29-მდე ფოტო გააანალიზოს.
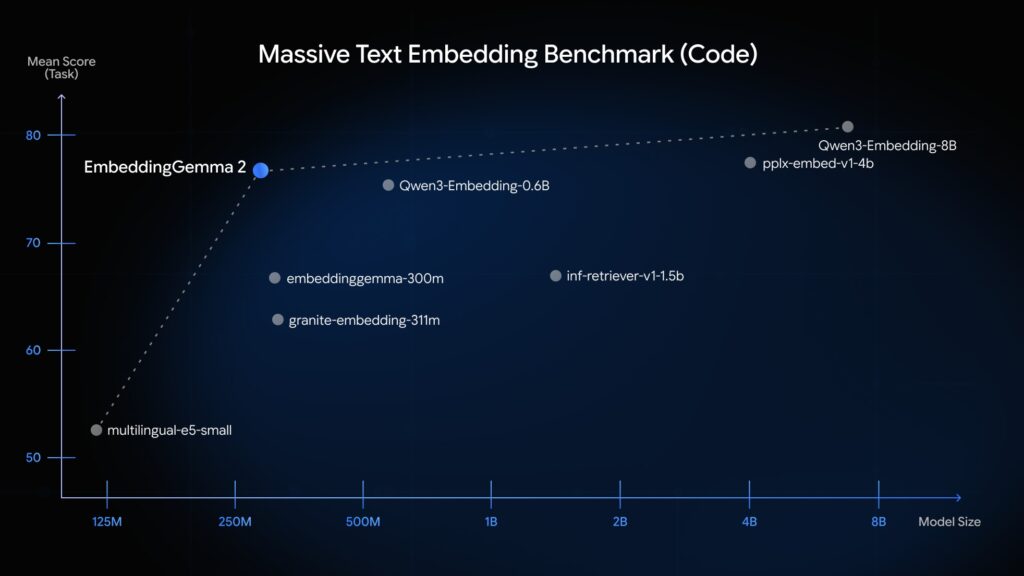
სიახლემ მნიშვნელოვანი პროგრესი აჩვენა პროგრამული კოდის ტესტებშიც. MTEB Code ბენჩმარკზე მისი შედეგი თითქმის 10 ქულით გაუმჯობესდა და 78.68 შეადგინა. ამასთან, ის ინარჩუნებს 100-ზე მეტი ენის გაგების უნარს. მოდელი გაწვრთნილია 140-ზე მეტ ენაზე არსებულ ვებგვერდებზე, თუმცა ავტორები აზუსტებენ, რომ ტექსტის გააზრების სიზუსტე ყველა ენაზე თანაბარი არ არის.
ახალი მოდელი იდეალურად მუშაობს დიდ ენობრივ მოდელებთან ერთად. ვინაიდან ის Gemma 4-თან საერთო ტოკენიზატორსა და აუდიოენკოდერს იყოფს, მათი ერთდროულად გაშვება მოწყობილობაზე გაცილებით ნაკლებ მეხსიერებას მოითხოვს და ძიების პროცესს (RAG) ამარტივებს.
Google AI Edge Gallery-ში უკვე გამოჩნდა მოდელის პრაქტიკული დემოები. ერთ-ერთი მათგანი, სახელად Video Moments Finder, ტექსტით ან ხმით ვიდეოში კონკრეტულ კადრებს პოულობს. Mac-ის მომხმარებლებისთვის კი ხელმისაწვდომია ინსტრუმენტი Foresight, რომელიც სამუშაო შეხვედრებისას ჩანაწერებს აკეთებს და ძიების ფუნქციას ინტერნეტის გარეშე ასრულებს. MediaPipe-ის მეშვეობით დეველოპერებს შეუძლიათ მოდელი ნულოვანი სწავლების კლასიფიკაციისთვისაც გამოიყენონ – მაგალითად, საჭადრაკო აპლიკაციაში სისტემამ 500 შესაძლო სვლა 100 მილიწამზე ნაკლებ დროში შეაფასა.
პროექტი კომერციულად სრულად ღიაა. მოდელის ფაილები Hugging Face-სა და Kaggle-ზე უკვე აიტვირთა. ინტეგრაცია ისეთ პოპულარულ ინსტრუმენტებთან, როგორებიცაა vLLM და Llama.cpp, უკვე ხელმისაწვდომია. უახლოეს კვირებში მოდელი Android-ის სისტემაში პირდაპირ დაემატება, სადაც ტელეფონის NPU პროცესორის სრული სიმძლავრით ისარგებლებს, ხოლო კორპორატიული მომხმარებლებისთვის ის მალე Gemini Enterprise კატალოგშიც გამოჩნდება.
| პარამეტრების საერთო რაოდენობა | 740 მილიონი |
| ტექსტისა და კოდის ბლოკი | 270 მილიონი |
| კონტექსტის ფანჯარა | 8,192 ტოკენი |
| ვექტორული განზომილება | 768-განზომილებიანი |
| სრული მოდელის ზომა ტელეფონზე | ~567 MB (Pixel 11 Pro) |
| ტექსტური ვერსიის ზომა ტელეფონზე | ~191 MB (Pixel 11 Pro) |
წყარო: Google DeepMind / blog.google | Google Developers Blog – Developer Guide | Google Developers Blog – AI Edge | EmbeddingGemma 2 model card
ეს სტატია შეიქმნა AI ხელსაწყოებით, პროცესში ადამიანის ჩართულობა დაახლოებით 10%-ია.