ხელოვნური ინტელექტის მიერ დაწერილ აბზაცს მალე ბრაუზერიდან ტექსტის უბრალო კოპირებაც ვეღარ გაათავისუფლებს ციფრული წარმომავლობისგან. ევროკავშირის მკაცრი წესების ამოქმედების შემდეგ გენერაციული მოდელების შემქმნელები იძულებულნი არიან, გამომავალი შინაარსის იდენტიფიცირება მანქანურად წაკითხვადი მეთოდებით უზრუნველყონ.
OpenAI-მ ევროკავშირის ტერიტორიაზე მყოფი მომხმარებლებისთვის ChatGPT-ისა და Codex-ის მიერ გენერირებულ ტექსტებში უხილავი წყლის ნიშნის ჩაშენება დაიწყო. კომპანიამ 5 ოქტომბერს გამოაქვეყნა სტრატეგიული დოკუმენტი, რომლითაც ევროკავშირის ხელოვნური ინტელექტის აქტის (EU AI Act) მოთხოვნებს პასუხობს. აღნიშნული კანონის გამჭვირვალობის წესები 2 აგვისტოდან შევიდა ძალაში და ხელოვნური ინტელექტის მომწოდებლებს ავალდებულებს, შექმნილი ტექსტი ცნობადი გახადონ.
როგორ მუშაობს ტექნოლოგია
ტექნოლოგიას textGrain ეწოდება. ის ტექსტში ხილულ სიმბოლოებს კი არ ამატებს, არამედ სიტყვების შერჩევის პროცესში უხილავ სტატისტიკურ სიგნალს აქსოვს. ვინაიდან ნიშანი უშუალოდ სიტყვების წყობაში ცხოვრობს, ის კოპირებულ და სხვაგან ჩასმულ ტექსტსაც მიჰყვება. მის ამოსაცნობად სპეციალური დეტექტორი გამოიყენება, რომელიც საიდუმლო გასაღების მეშვეობით ეძებს კონკრეტულ მათემატიკურ კანონზომიერებას. ტექნიკური ანგარიში OpenAI-მ University of Pennsylvania-სა და Yale-ის მკვლევრებთან ერთად შეიმუშავა და კომპანია ამ ტექნოლოგიის ღია კოდით (open source) გამოშვებას აპირებს. მათი განმარტებით, textGrain-მა აჯობა ან გაუთანაბრდა სხვა მიდგომებს, მათ შორის, Google-ის სისტემა SynthID-ს, თანაც ისე, რომ კომპანიის უახლესი ფლაგმანი მოდელის, Astra-ს, წარმადობა ბენჩმარკებში არ დაუწევია.
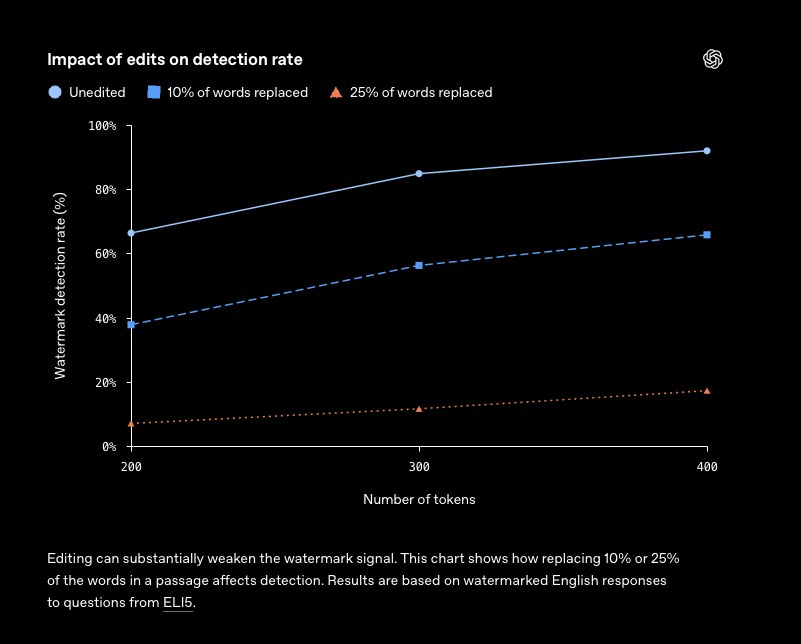
მიუხედავად ამისა, სისტემას მკაფიო შეზღუდვები აქვს. 1%-იანი ცრუ დადებითი მაჩვენებლის მიზნის პირობებში ფსიქოლოგიური ტიპის შინაარსზე სისტემამ 400-ტოკენიანი მონაკვეთების დაახლოებით 95% ამოიცნო, ხოლო 200-ტოკენიანი პასაჟების მხოლოდ 80%. მათემატიკურ ამოცანებში სიტყვების არჩევანი მკაცრად შეზღუდულია, რის გამოც იქ ამოცნობის შედეგი გაცილებით დაბალია. ამასთან, ტექსტის რედაქტირება ნიშანს ასუსტებს: სიტყვების 10%-ის სინონიმებით ჩანაცვლებამ ამოცნობა 92%-დან 66%-მდე შეამცირა, ხოლო 25%-ის შეცვლამ შედეგი 17%-მდე ჩამოიყვანა. მოკლე პასაჟები, მათემატიკური პასუხები და ნათარგმნი ტექსტები ბევრად უფრო რთულად იშიფრება.
დანერგვის ეტაპები და შეზღუდვები
OpenAI-მ პროცესი სამ ნაწილად დაყო. პირველ ეტაპზე, მომდევნო კვირების განმავლობაში, წყლის ნიშანი მხოლოდ ევროკავშირში მყოფი მომხმარებლებისთვის ჩაირთვება, ყველა სატარიფო გეგმაზე. კომპანია ხაზგასმით აღნიშნავს, რომ ეს ფუნქცია გლობალურ ნაგულისხმევ სტანდარტად არ იქცევა. მეორე ეტაპზე, 5 ოქტომბრიდან, API-ის მომხმარებლებს მთელ მსოფლიოში შეეძლებათ, სურვილისამებრ გაააქტიურონ მონიშვნა ცალკეული მოდელებისთვის, თუმცა ის ნაგულისხმევად გამორთულია. მესამე კომპონენტი თავად დეტექტორია: მასზე განაცხადების მიღება უკვე დაიწყო, მაგრამ წვდომა მხოლოდ შემოწმებულ მკვლევრებსა და ექსპერტულ ორგანიზაციებზე გაიცემა, რადგან საჯარო ვერსიას ცრუ განგაშისა და გამოტოვებული ნიშნების რისკი ახლავს.
OpenAI პირდაპირ განმარტავს, რას არ აკეთებს ახალი წყლის ნიშანი: ის არ ახდენს მომხმარებლის, ანგარიშის, პრომპტისა თუ დიალოგის იდენტიფიცირებას და არ ზომავს ადამიანის წვლილს, საავტორო უფლებას ან სისწორეს. როგორც კომპანიაში აცხადებენ, წყლის ნიშნებს შეუძლია მიუთითოს, რომ ტექსტის ნაწილი OpenAI-ს სისტემამ შექმნა ან დაამუშავა, მაგრამ ვერ განსაზღვრავს, რამდენი ადამიანური მსჯელობა, რედაქტირება თუ კრეატიულობა ჩაიდო მასში. ამასთან, ნიშნის არარსებობა არ ამტკიცებს ადამიანის ავტორობას, რადგან ტექსტი შესაძლოა ზედმეტად მოკლე იყოს, შეცვლილი, ნათარგმნი ან სულაც სხვა კომპანიის სისტემით გენერირებული.
ტექსტის მონიშვნა ინდუსტრიაში დიდი ხანია კამათის საგანია. ორი თვით ადრე Anthropic-მა განაცხადა, რომ Claude-ის ტექსტებს მთელ მსოფლიოში მონიშნავდა, რასაც მომხმარებლების ნაწილის უკმაყოფილება მოჰყვა. The Wall Street Journal ჯერ კიდევ 2024 წელს წერდა, რომ OpenAI-ს ტექსტის წყლის ნიშანი უკვე მზად ჰქონდა, თუმცა გაშვებას აყოვნებდა, მათ შორის, იმ შიშით, რომ მომხმარებლები კონკურენტებთან გადავიდოდნენ. დღეს Anthropic, Google, Meta, Microsoft და OpenAI იმ კომპანიებს შორის არიან, რომლებმაც აიღეს ვალდებულება ევროკავშირის ქცევის კოდექსზე ხელოვნური ინტელექტის გენერირებულ კონტენტთან დაკავშირებით. სურათებსა და აუდიოზე OpenAI უკვე იყენებს C2PA Content Credentials-სა და SynthID-ს და მუშაობს გადამოწმების გვერდი openai.com/verify.
საქართველოს მომხმარებლებისთვის ეს სიახლე ამ ეტაპზე პირდაპირ არ ამოქმედდება. რადგან ქვეყანა ევროკავშირის წევრი არ არის, ევროპული ბაზრისთვის დაწესებული რეგულაციები და ავტომატური მარკირება აქ ნაგულისხმევად არ გავრცელდება.
წყარო: OpenAI | TechCrunch | The Verge