AI აგენტების რბოლაში Anthropic ახალ ეტაპზე გადადის: კომპანიამ Claude Sonnet 5.5 წარადგინა, მოდელი, რომელიც ყოველდღიურ პროგრამირებას, დოკუმენტებთან მუშაობას, მონაცემების დამუშავებასა და სხვა სამუშაო პროცესებს უფრო სწრაფად და ნაკლები დანახარჯით ასრულებს. ეს Claude 5.5 ოჯახის მეორე წევრია Claude Opus 5.5-ის შემდეგ და Anthropic-ის პოზიციონირებით, სწორედ ის არის მოდელი, რომელიც მომხმარებლების დიდი ნაწილის ყოველდღიურ ამოცანებზეა გათვლილი.
Claude Sonnet 5.5 არ ცდილობს Opus 5.5-ის ჩანაცვლებას. Anthropic-ის მიხედვით, Opus კვლავ უფრო ძლიერია რთულ, ღია ტიპის ამოცანებში, სადაც საჭიროა ხანგრძლივი მსჯელობა და მაღალი დონის შეფასება. Sonnet 5.5 კი აქცენტს აკეთებს სიჩქარეზე, კოდინგზე, შეცდომების პოვნაზე, პრეზენტაციებზე, ცხრილებზე, დოკუმენტებსა და სხვა პრაქტიკულ სამუშაოებზე.
მეტი სიჩქარე, იგივე ფასი
ახალი მოდელის ერთ-ერთი მთავარი ცვლილება შესრულების ტემპია. Anthropic-ის მიხედვით, Claude Sonnet 5.5 Claude Sonnet 5-ზე 30%-ზე მეტად სწრაფია. ამასთან, კონკრეტული ამოცანის შესრულება ზოგ შემთხვევაში 30%-მდე ნაკლები ჯდება, რადგან მოდელი სამუშაოს ნაკლები ტოკენით ასრულებს.
ფასები უცვლელია:
შესავალი ტოკენები: $2 მილიონ ტოკენზე
გამომავალი ტოკენები: $10 მილიონ ტოკენზე
Cache read: $0.20 მილიონ ტოკენზე
შედარებისთვის, Claude Opus 5.5-ის ფასი $4/$20-ია მილიონ ტოკენზე. შესაბამისად, Sonnet 5.5 Anthropic-ის უფრო მასშტაბური ყოველდღიური გამოყენებისთვის განკუთვნილ შეთავაზებად რჩება.
ტექნიკური ბირთვი
Claude Sonnet 5.5-ის მოდელის იდენტიფიკატორია claude-sonnet-5-5. მას აქვს 1 მილიონი ტოკენის კონტექსტის მხარდაჭერა, მაქსიმალური გამომავალი მოცულობა 128 ათასი ტოკენია, ხოლო ცოდნის ბოლო განახლება 2026 წლის ივნისით თარიღდება.
მოდელს აქვს adaptive thinking რეჟიმი. Claude Platform-ზე ნაგულისხმევი ძალისხმევის დონე მაღალია, ხოლო Claude აპებში საშუალო დონეზე მუშაობს.
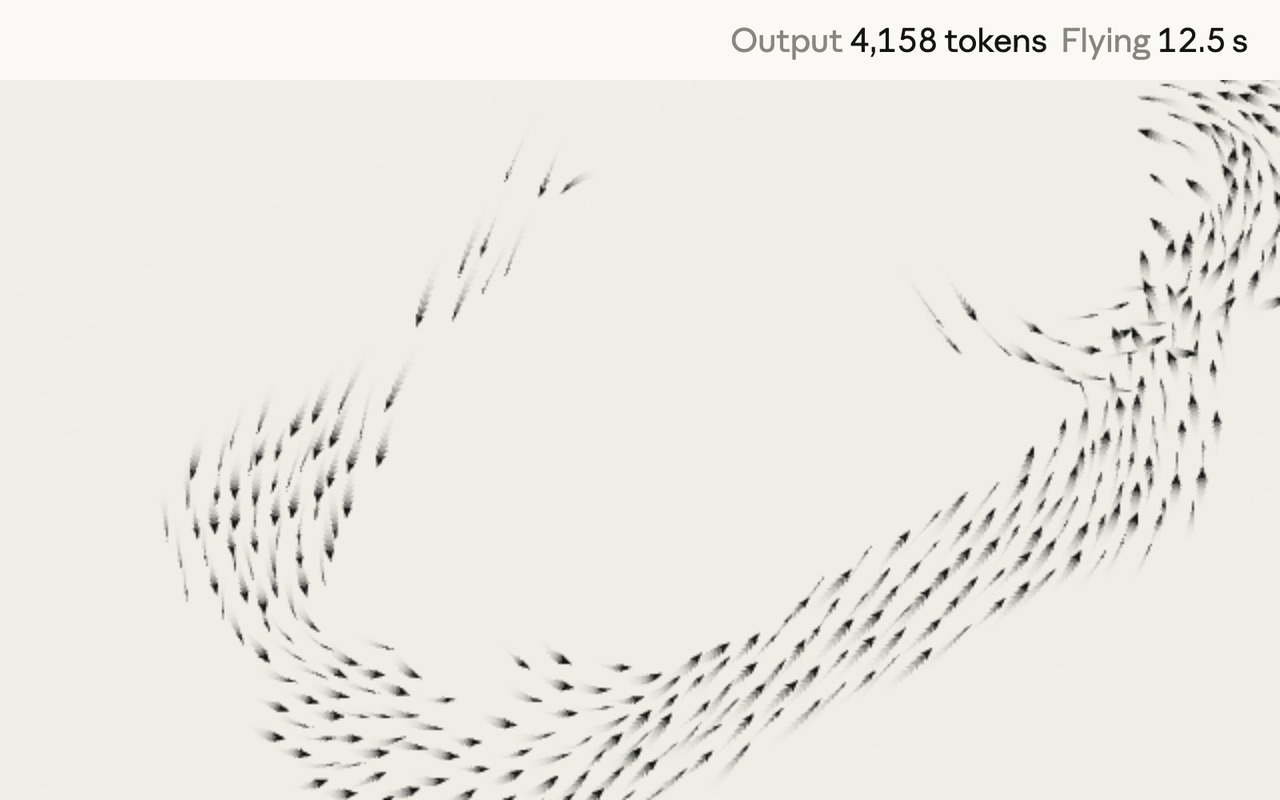
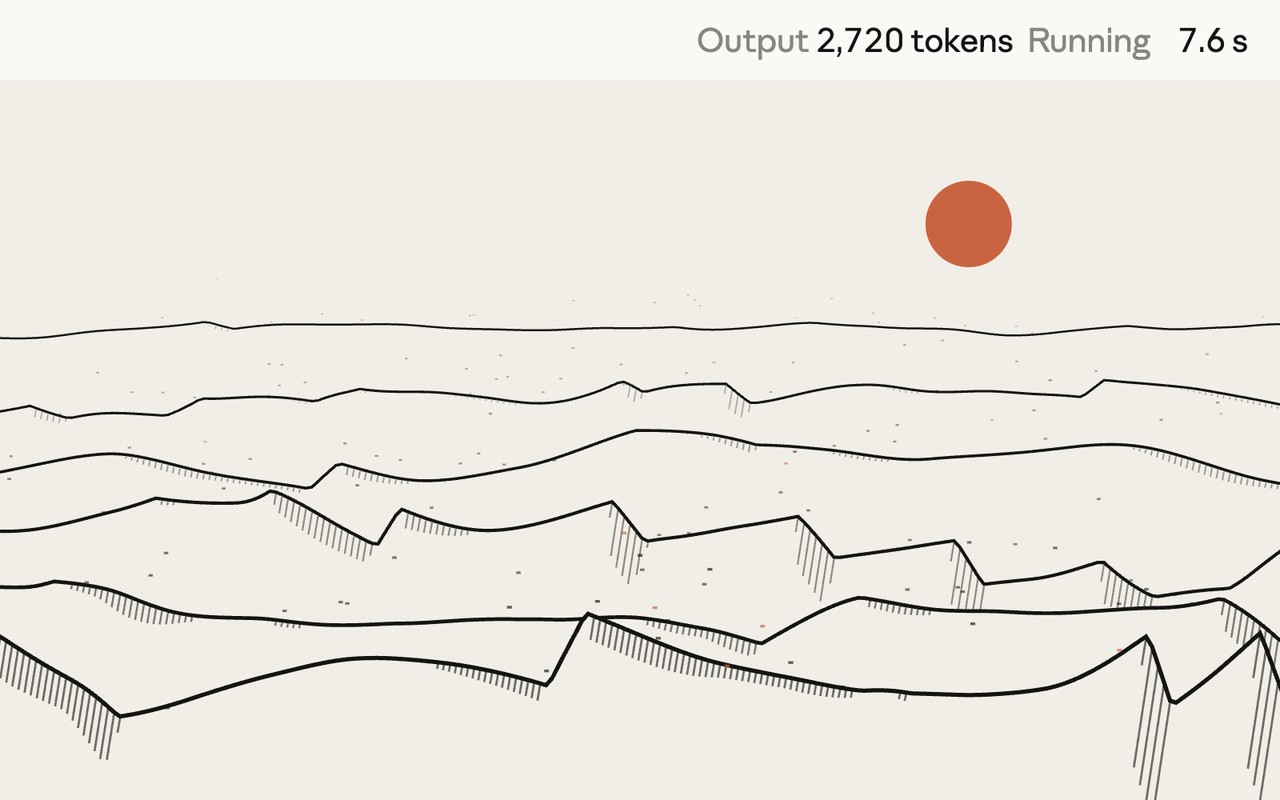
Anthropic-ის შიდა და საჯარო დემოებში ცვლილება მხოლოდ ციფრებში არ ჩანს. კომპანიამ გვერდიგვერდ აჩვენა Sonnet 5-ისა და Sonnet 5.5-ის მიერ შექმნილი რამდენიმე ვიზუალური და ინტერაქტიული მაგალითი, მათ შორის 400 სტარლინგისგან შემდგარი murmuration-ის HTML ვერსია, ქვიშის დიუნების ვიზუალიზაცია და clock-of-clocks. ამ დემოებით Anthropic ცდილობს აჩვენოს, როგორ იცვლება მოდელის შედეგი მაშინ, როდესაც მას იგივე ტიპის შემოქმედებით და ტექნიკურ დავალებას აძლევენ.
ბენჩმარკებში დიდი ნახტომი
შესრულება
Sonnet 5.5 Sonnet 5-ს რამდენიმე მიმართულებით აჭარბებს, ზოგან კი მკვეთრად. რამდენიმე ტესტში Max ძალისხმევაზე ის Opus 5.5-საც უახლოვდება. Anthropic აღნიშნავს, რომ ბენჩმარკები მოდელის შესაძლებლობების მხოლოდ ერთი საზომია და Opus 5.5 კვლავ უფრო ძლიერია რთულ, ღია ტიპის ამოცანებში.
Anthropic-ის ოთხი მთავარი შედარება (ოფიციალური ქულები). სრული accuracy vs. cost გრაფიკები: anthropic.com
Agentic terminal coding · Terminal-Bench 4.0
ზომავს რთულ, მრავალსაფეხურიან პროფესიულ ამოცანებს ბრძანების სტრიქონის გარემოში.
Agentic coding · FrontierCode 1.1 (Main)
ამოწმებს, შეიძლება თუ არა აგენტის კოდის ცვლილება merge-ის გარეშე მიიღონ. Sonnet 5.5-ის Xhigh შედეგი Max-ზე მაღალია.
Agentic coding · CursorBench 4.0
აფასებს კოდინგ აგენტებს რეალური Cursor სესიებიდან აღებულ მრავალფაილიან ამოცანებზე.
Knowledge work · AA-Briefcase v1.1
გრძელვადიანი knowledge work-ის ბენჩმარკი. სვეტების სიგანე შედარებითია (Opus = 100%).
Anthropic-ის ტესტებში Sonnet 5.5 განსაკუთრებით გამოირჩევა კოდინგისა და აგენტური მუშაობის მიმართულებით. Terminal-Bench 4.0-ში მოდელმა 70.6% მიიღო, მაშინ როდესაც Sonnet 5-ის შედეგი 10.3%, ხოლო Opus 5.5-ის 66.4% იყო.
FrontierCode 1.1 Main-ში Sonnet 5.5-მა Max რეჟიმში 46.2%, Xhigh რეჟიმში კი 52.1% აჩვენა. შედარებისთვის, Sonnet 5-ის შედეგი 42.4%, Opus 5.5-ის 54.4%, ხოლო GPT-6 Sol-ის 49.3% იყო.
CursorBench 4.0-ში Sonnet 5.5-ის შედეგი 55.5%-ია, Sonnet 5-ის 34.1%-თან და Opus 5.5-ის 57.8%-თან შედარებით. GDPval-AA v2.1-ში მოდელმა 1844 ქულა მიიღო, Sonnet 5-ის 1449-თან, Opus 5.5-ის 1846-თან და GPT-6 Sol-ის 1487-თან შედარებით.
სხვა ტესტებიც აჩვენებს, რომ მოდელის შესაძლებლობები მხოლოდ პროგრამირების ამოცანებით არ შემოიფარგლება. HLE with tools-ში Sonnet 5.5-ის შედეგი 64.5%-ია, Sonnet 5-ის 54.9%-თან და Opus 5.5-ის 67.7%-თან შედარებით. OSWorld 2.1-ში Sonnet 5.5-მა 80.1% აჩვენა, Sonnet 5-ის 57.0%-თან და Opus 5.5-ის 81.8%-თან შედარებით.
Chartography no tools-ის ტესტში Sonnet 5.5-ის შედეგი 61.6%-ია, Sonnet 5-ის 15.6%-თან და Opus 5.5-ის 64.4%-თან შედარებით. AA-Briefcase v1.1-ში კი მოდელმა 1811 ქულა მიიღო, მაშინ როდესაც Sonnet 5-მა 1359, Opus 5.5-მა 1822, ხოლო GPT-6 Sol-მა 1483 ქულა აჩვენა.
Anthropic აღნიშნავს, რომ ბენჩმარკები მოდელის შესაძლებლობების მხოლოდ ერთი საზომია და Opus 5.5 კვლავ ინარჩუნებს უპირატესობას რთულ, ღია ტიპის ამოცანებში.
ნაკლები ნაბიჯი, ნაკლები ტოკენი
Anthropic-ის ერთ-ერთი საინტერესო მაგალითი Slack-ის სამუშაო პროცესებიდან მოდის. კომპანიის მიხედვით, Slack-ის შეფასებებში Sonnet 5.5 Sonnet 5-ზე თითქმის ყველა offline Slackbot eval-ში უკეთეს შედეგს აჩვენებდა. ამასთან, მოდელს ამოცანების შესასრულებლად ნაკლები ნაბიჯი სჭირდებოდა და დაახლოებით 14%-ით ნაკლებ გამომავალ ტოკენს იყენებდა.
ეს განსხვავება განსაკუთრებით მნიშვნელოვანია აგენტურ სისტემებში, სადაც ერთი მოთხოვნა შეიძლება რამდენიმე მოქმედებად დაიყოს. ნაკლები ნაბიჯი და ნაკლები გამომავალი ტოკენი ერთდროულად ნიშნავს უფრო სწრაფ შესრულებას და იმავე სამუშაოსთვის რესურსების შემცირებას.
კოდინგიდან თამაშის შექმნამდე
Sonnet 5.5-ის ერთ-ერთი მთავარი მიმართულება პროგრამული უზრუნველყოფის შექმნაა. Anthropic-ის ადრეულმა მომხმარებლებმა აღნიშნეს, რომ ახალი მოდელი რთულ სამუშაო პროცესებს ნაკლები მითითებით ასრულებს.
Epic-ის COO Daniel Vogel-ის თქმით, გუნდმა Sonnet 5.5-ის გამოყენებით შეძლო უფრო მაღალი ხარისხის ზღვრის გადალახვა, მათ შორის ათიათასობით ხაზის კოდის მქონე თამაშის არქიტექტურის სამუშაოებში. მისი შეფასებით, მოდელი სწრაფად რეაგირებდა და მრავალსაათიანი ამოცანებისთვის ნაკლებად საჭიროებდა ზედმეტად დეტალურ მითითებებს.
SpaceXAI-ის Sualeh Asif-მა აღნიშნა, რომ CursorBench-ის 55.5%-იანი შედეგი აჩვენებს მოდელის მაღალ შესაძლებლობებს და, ამავდროულად, ინარჩუნებს შესრულებისა და ფასის ბალანსს.
Sonnet 5.5 ასევე პირველი Sonnet მოდელია, რომელმაც Pokémon Red-ის თამაში მხოლოდ ეკრანის სურათების მიხედვით შეძლო. ეს მაგალითი აჩვენებს, რომ მოდელის გამოყენება მხოლოდ კოდის წერით არ შემოიფარგლება და მას შეუძლია ვიზუალური ინფორმაციის აღქმა და პროგრამულ გარემოში მოქმედება.
უსაფრთხოება და გადასვლა ახალ მოდელზე
Anthropic-მა Sonnet 5.5-ში პირველად Sonnet-ის სერიაში დაამატა კიბერუსაფრთხოების დაცვის მექანიზმები, რომლებიც Opus 5.5-ის მსგავს მიდგომას იყენებს. მაღალი რისკის კიბერსცენარებში სისტემა კვლავ Sonnet 5-ზე გადადის. ბიოლოგიური უსაფრთხოების დაცვის დონე კი Sonnet 5-ის მსგავსად რჩება.
კომპანიამ ასევე შეინარჩუნა მოდელის მსჯელობის დაცვის მექანიზმები და გამოიყენა კლასიფიკატორები დისტილაციისა და reasoning extraction-ის რისკების შესამცირებლად.
მომხმარებლებს, რომლებიც Sonnet-ს thinking რეჟიმის გარეშე იყენებდნენ, Anthropic ურჩევს Sonnet 5.5-ზე გადასვლისას between_tools რეჟიმის გამოყენებას, რათა წინასწარი მსჯელობის გამორთული რეჟიმი შენარჩუნდეს.
Anthropic ასევე სთავაზობს Zero Data Retention-ს, რაც შესაბამისი გამოყენების შემთხვევაში მომხმარებლებს საშუალებას აძლევს, მოდელის მუშაობისას მონაცემთა შენახვა გამორთონ.
სად არის ხელმისაწვდომი
Claude Sonnet 5.5 უკვე ხელმისაწვდომია Claude API-ში და ღრუბლოვან პლატფორმებში:
Amazon Bedrock
Google Cloud
Microsoft Foundry და Azure
Claude API-ში გამოიყენება მოდელის სახელი claude-sonnet-5-5, ხოლო პარტნიორულ პლატფორმებზე იგივე იდენტიფიკატორი გამოიყენება.
Anthropic-ისთვის Sonnet 5.5 ასევე უფრო ფართო მოდელების ხაზის ნაწილია. Opus 5.5 უკვე წარმოდგენილია როგორც უფრო რთული ამოცანებისთვის განკუთვნილი მოდელი, ხოლო კომპანია Claude Haiku 5.5-ის გამოშვებას უახლოეს კვირებში გეგმავს. Haiku 5.5 უფრო მაღალი მოცულობის და ფასზე ორიენტირებული გამოყენებისთვის იქნება განკუთვნილი.
ამგვარად, Anthropic Claude 5.5 ოჯახს სამი განსხვავებული გამოყენების მიმართულებით აწყობს: Opus რთული და ხანგრძლივი ამოცანებისთვის, Sonnet სწრაფი და ყოველდღიური სამუშაოებისთვის, ხოლო Haiku უფრო მასშტაბური გამოყენებისთვის. Sonnet 5.5-ის მთავარი ცვლილება ამ სქემაში სიჩქარის ზრდაა, რომელიც კომპანიას საშუალებას აძლევს, უფრო მძიმე აგენტური სამუშაოები ყოველდღიურ გამოყენებასთან დააბალანსოს.